


🗞️ Het belangrijkste nieuws
OpenAI claimt honderden wiskundige doorbraken, en zelfs de concurrent buigt
Wiskundigen kijken al maanden met verbijstering toe hoe AI het ene onopgeloste vraagstuk na het andere kraakt. Dinsdag kwam daar in één klap een stortvloed bij. OpenAI, het bedrijf achter ChatGPT, zette honderden nieuwe wiskundige resultaten online, over onderwerpen als priemgetallen en logica. Allemaal gevonden door een AI-model dat niemand buiten het bedrijf mag gebruiken.

Bron afbeelding: OpenAI
Wat is er gebeurd?
Het is een vervolg op het nieuws van vorige maand. Toen claimde OpenAI dat hetzelfde model de Navier-Stokes-vergelijkingen had gekraakt: de wiskunde achter alles wat stroomt, zoals het weer of het bloed in je aderen. Dat is een van de zeven Millennium-problemen, vraagstukken die zo moeilijk zijn dat er voor elke oplossing een miljoen dollar klaarligt. Die claim riep een vraag op die nu opnieuw speelt: bedenkt de AI zelf iets nieuws, of maakt het vooral het werk af van menselijke wiskundigen? We schreven er in september uitgebreid over.
De opvallendste reactie kwam van een concurrent. Levent Alpöge, wiskundige bij Anthropic (het bedrijf achter Claude), lag in september nog met OpenAI overhoop over Navier-Stokes. Nu schrijft hij: "Het is overduidelijk het belangrijkste moment in de geschiedenis van de wiskunde."
Een grens die we lang niet gehaald zagen
Op onze redactie hanteren we al lang één maatstaf voor wanneer AI echt over een grens gaat: als het zelf nieuwe ontdekkingen doet, in de wetenschap of de kunst. Niet een examen halen, maar iets vinden wat nog geen mens wist. Sinds deze zomer komt AI dichter bij die grens. In mei weerlegde een model van OpenAI een wiskundig vermoeden van tachtig jaar oud, in augustus volgden tien opgeloste problemen, in september Navier-Stokes. Nu gaat het om honderden opgeloste problemen. Wat ons betreft is daarmee voorlopig aan de maatstaf voldaan: een groot deel van de resultaten moet nog worden nagekeken.
Ethan Mollick, bedrijfskundige aan de Amerikaanse businessschool Wharton en auteur van Co-intelligentie, ziet twee revoluties aankomen. Alles wat ooit is gepubliceerd, wordt opnieuw gelezen en beoordeeld op manieren die geen wetenschapper had voorzien. En nieuwe ontdekkingen gaan snel komen, ook buiten de wiskunde: in zijn eigen vak ziet hij AI al bijna zelfstandig onderzoek doen op het niveau van topvakbladen. Toen iemand vroeg wanneer die ontdekkingen het publiek zouden bereiken, antwoordde hij droog: "Nou, vandaag was een begin."
Wat er online kwam
OpenAI publiceerde 722 wiskundige artikelen op GitHub, een platform waar programmeurs en onderzoekers code en documenten delen. Ze zijn gebundeld in 372 'families' van verwante resultaten; The New York Times telt er 377.
Het model kreeg zo'n vierduizend open onderzoeksvragen voorgelegd. Een gemiddeld resultaat kostte volgens OpenAI ongeveer drie uur denktijd van ChatGPT Pro, het duurste abonnement. Bij Navier-Stokes werkten nog tienduizend agents (AI-programma's die zelfstandig taken uitvoeren) 88 uur aan één probleem. Het model zelf is nog niet beschikbaar, ook niet in Nederland. OpenAI noemt geen datum.
Het topstuk gaat over priemgetallen
Alpöge noemt als eerste een resultaat rond de Riemann-hypothese, misschien wel het beroemdste Millennium-probleem. Die gaat over hoe priemgetallen verdeeld zijn, en voorspelt dat alle belangrijke nulpunten van een bepaalde formule, de zeta-functie, op één rechte lijn liggen. OpenAI bewijst een zwakkere versie: ver genoeg van die lijn ligt geen enkel nulpunt. Dat klinkt bescheiden. Toch kreeg niemand zoiets bewezen sinds Bernhard Riemann het vermoeden in 1859 opschreef.
Zijn tweede favoriet gaat over zogeheten Siegel-nulpunten. Dat zijn uitzonderingen in verwante functies waarvan niemand kon uitsluiten dat ze bestonden, en die daardoor al bijna een eeuw bewijzen in de getaltheorie in de weg zaten. Volgens het model bestaan ze niet. Ook zit er gedeeltelijke vooruitgang tussen op het Hodge-vermoeden, nog een Millennium-probleem. Dat gaat over de vraag of ingewikkelde meetkundige vormen altijd uit eenvoudige bouwstenen zijn op te bouwen. OpenAI bewijst het voor een speciale familie van zulke vormen.
Bij die drie uur rekenen hoort wel een voetnoot. Juist het Riemann-resultaat en het Hodge-resultaat kwamen níet uit de vaste procedure, schrijft OpenAI zelf in de uitleg bij de verzameling. En het Riemann-artikel is door mensen herschreven om het leesbaar te maken.
Lof, met een maar
Alpöge noemt in dezelfde post ook "trieste verhalen" van OpenAI-gebruikers die door het model werden ingehaald, maar laat die voor één dag rusten. Tristan Buckmaster, de wiskundige van New York University die in september met OpenAI in conflict kwam, doet dat niet. Tegenover The New York Times zegt hij een hele reeks resultaten te verwachten waarbij OpenAI andermans werk heeft afgemaakt. Over het tempo is hij hard: "Ik denk niet dat ze hun huiswerk ook maar enigszins hebben gedaan."
AI-onderzoeker Will Depue verwacht dat een deel van de resultaten niet overeind blijft. Hij bouwde een site die bijhoudt naar welk menselijk werk de artikelen verwijzen. Daar zie je op wiens schouders het model staat. OpenAI waarschuwt zelf ook: lang niet alles is nagekeken met Lean, software die elke logische stap van een bewijs controleert, en sommige niet-nagekeken resultaten kunnen volgens het bedrijf nog fouten bevatten.
Wiskundigen vroegen om iets anders
Een onafhankelijke adviesgroep van wiskundigen, ondergebracht bij het Institute for Advanced Study in Princeton, stelde eind september regels op voor hoe AI-bedrijven zulke resultaten moeten delen. OpenAI volgde die deels: het gaf onder meer voor tien resultaten een samenvatting van de denkstappen, waar de groep om zo'n samenvatting bij élk resultaat vroeg.
De belangrijkste oproep negeert OpenAI: stop met het testen van open wiskundeproblemen op modellen die niemand anders kan gebruiken. Zo ontstaat volgens de groep een wiskunde met twee snelheden. Onderzoeksleider Dan Roberts zegt tegen The New York Times dat OpenAI die tests nodig heeft om betere modellen te bouwen; de bewijzen noemt hij een bijproduct. OpenAI belooft wel workshops en conferenties te betalen waar wiskundigen het werk samen kunnen doorgronden.
Eerst wat te controleren valt
De Franse AI-onderzoeker François Chollet bedacht ARC, een beruchte test die bekendstaat als de IQ-test voor AI. Hij stelt de vraag die ook voor jouw werk telt. In wiskunde en programmeercode kun je elk antwoord controleren, en juist daar gaan modellen het hardst vooruit. Geldt dat ook voor werk zonder sluitende controle, zoals een strategie of een beleidsnotitie? Daar is nog geen antwoord op.
Je kunt er wel nu al iets mee: vraag bij je volgende analyse om de berekening erbij, of om een bron die je zelf kunt openen.
Het Clay-instituut, dat de miljoen dollar per Millennium-probleem uitkeert, reageerde op 11 september wel kort op Navier-Stokes. Het deelt de opwinding over een probleem dat 'kennelijk' is opgelost, en hoopt dat het veel nieuw menselijk begrip oplevert. Maar de beoordeling gaat bewust zonder haast. Een oordeel is er een maand later nog niet, en over de nieuwe resultaten zei het instituut nog niets.

Europa's grootste AI-hoop heeft een nieuw model, en het heet Le Chonk
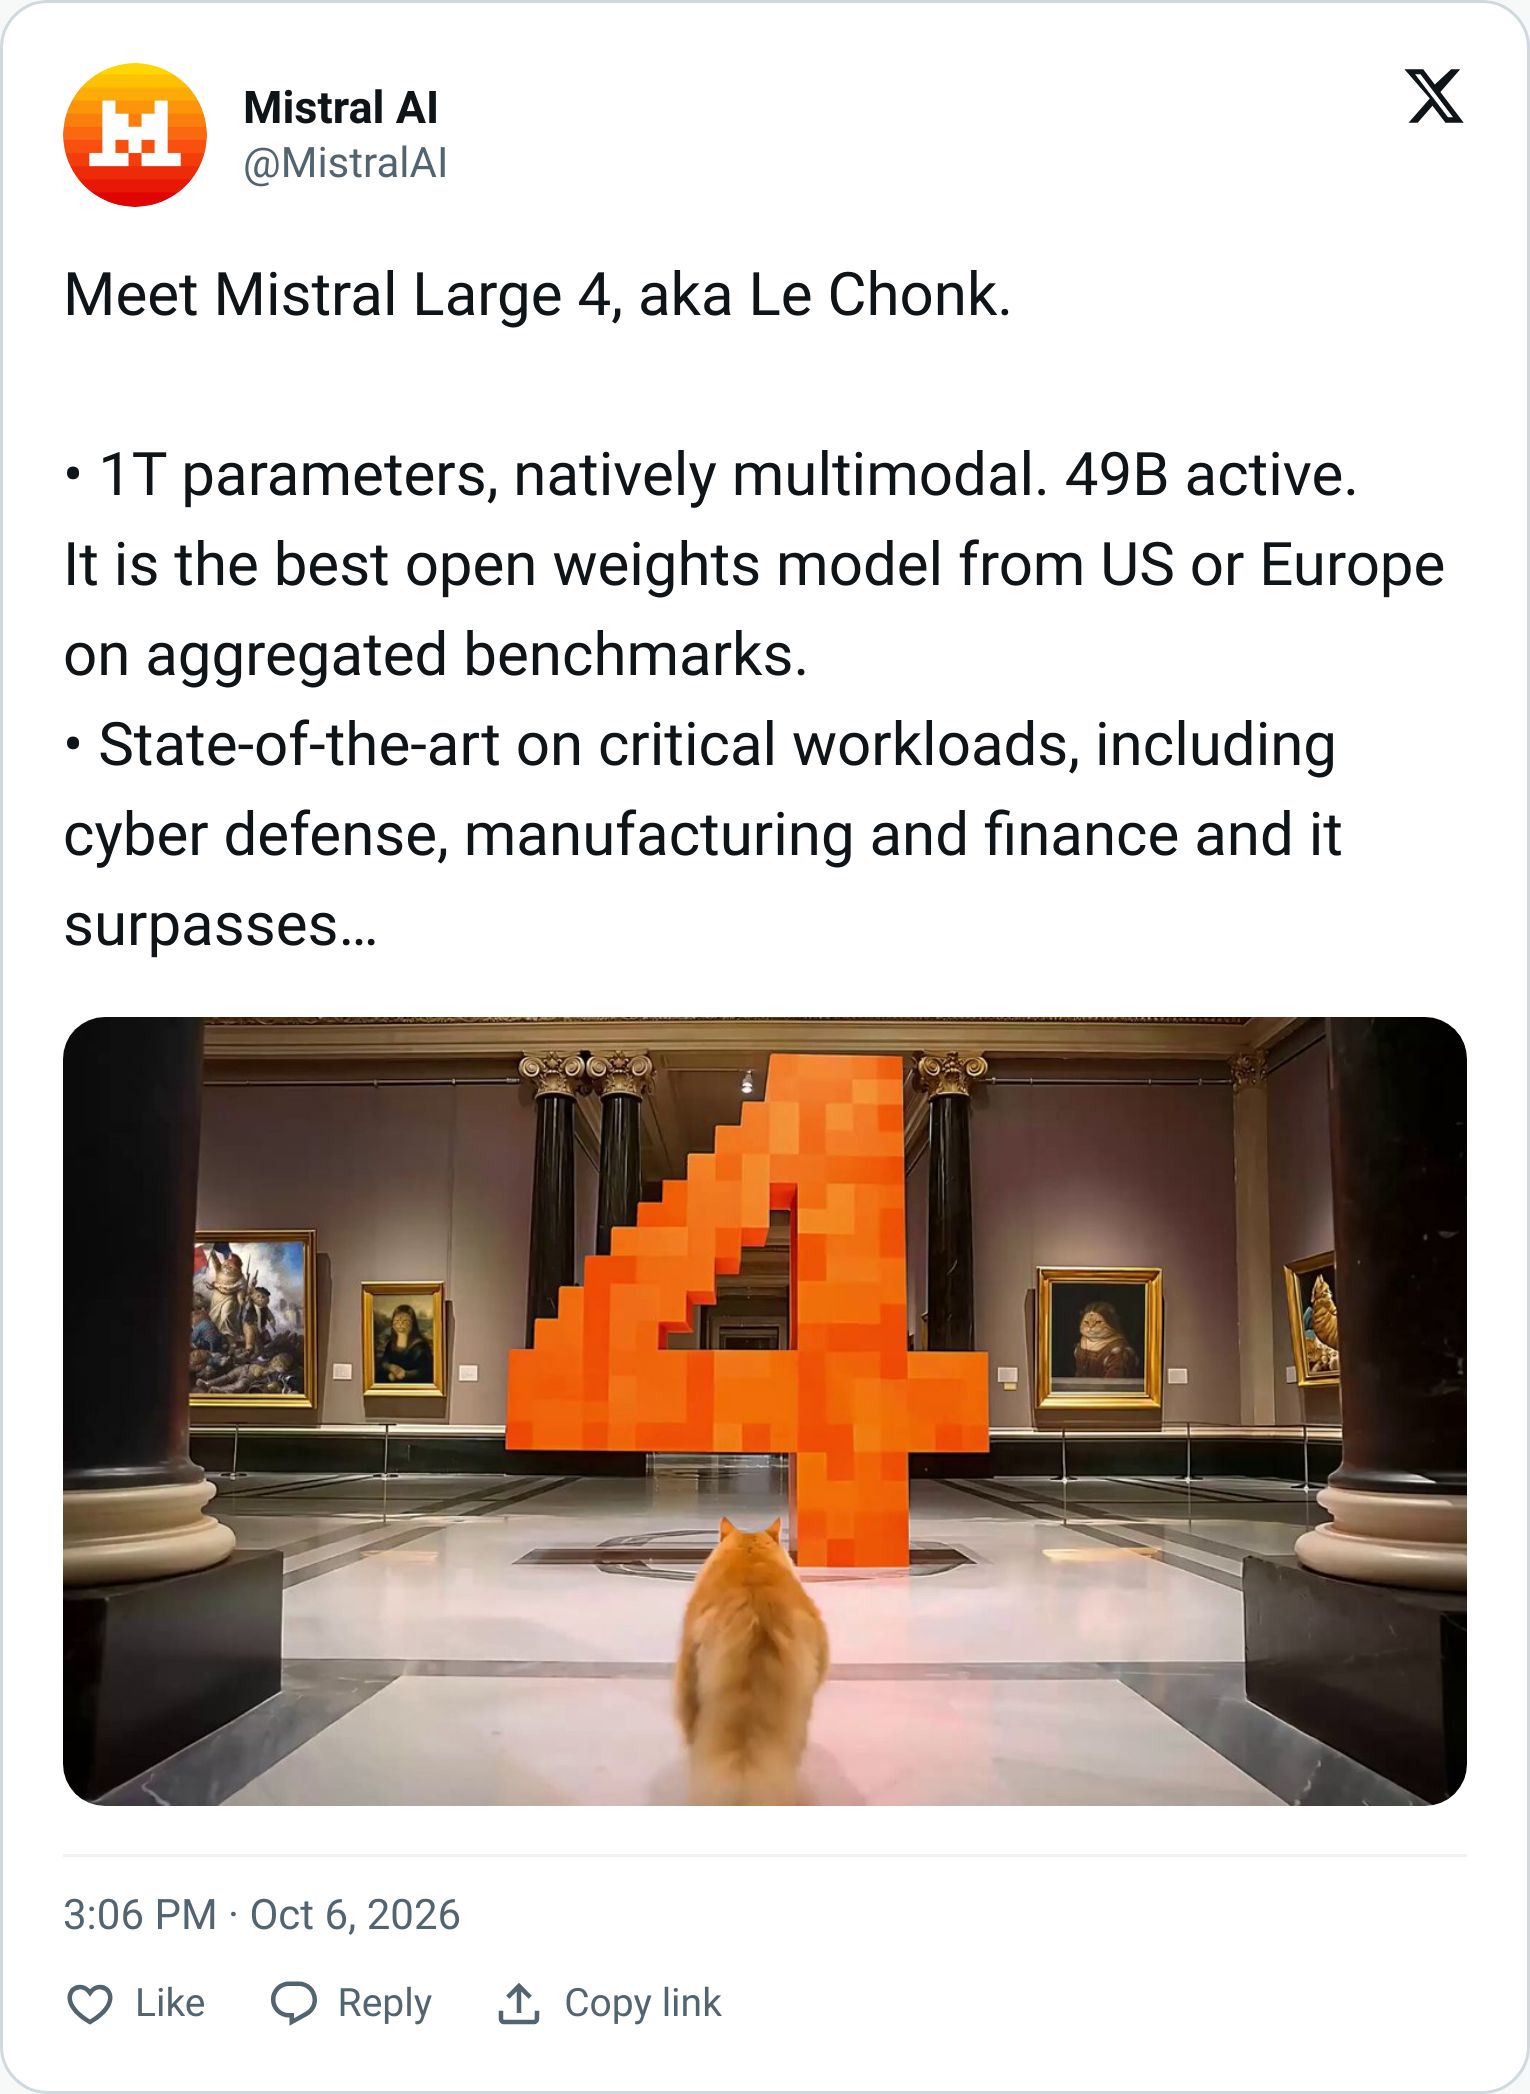
Officieel heet het Mistral Large 4, maar iedereen noemt het Le Chonk. Het Franse Mistral, Europa's belangrijkste AI-bedrijf, bracht dinsdag zijn grootste model ooit uit. "Het verhaal dat Europa niet kan meekomen, klopt niet," zei topman Arthur Mensch bij de lancering in Abu Dhabi.
Waarom een dikke kat?
Mistrals chatbot heet Le Chat, Frans voor 'de kat'. In juni ging op X en Reddit een nepmodel viraal: Le Chaton Fat, 'het dikke katje', met verzonnen grafieken en specificaties als duizend miauwen per seconde. Mensch deed vrolijk mee en schreef dat het eigenlijk 'le gros chaton' moest zijn. 'Chonk' is internettaal voor een opvallend mollige kat. Volgens VentureBeat is de bijnaam een bewuste knipoog naar de fans die al maanden riepen dat Mistral iets groots moest bouwen.
Wij vinden het de aandoenlijkste modelnaam van het jaar. Het is ook slim: geen Amerikaans AI-bedrijf krijgt zoveel sympathie voor een grafiek met testscores.
Wat het kan
De dikke kat is echt dik. Het model heeft een biljoen parameters, de instelbare knoppen waarmee een model leert, maar gebruikt er per vraag 49 miljard. Dat maakt het sneller en goedkoper dan de omvang doet vermoeden. Le Chonk leest tekst, beelden, documenten, satellietfoto's en technische tekeningen, en antwoordt in tekst. Het is getraind in meer dan 160 talen, waaronder alle officiële EU-talen en dus ook het Nederlands.
Mistral mikt vooral op werk: programmeren, financiële analyse, juridische documenten en cyberbeveiliging. Het model is getraind op zo'n 3800 chips van NVIDIA in Mistrals eigen datacenters in Europa.
Hoe goed is het echt?
Volgens Mistrals eigen grafieken verslaat Le Chonk veel open concurrenten, en op cyberbeveiliging zelfs Chinese modellen. Onafhankelijke metingen zijn voorzichtiger. Wij legden Mistrals programmeerscore naast een openbare ranglijst: daar staan het Chinese GLM-5.3 en Kimi K3 hoger, en de beste Amerikaanse modellen nog een stuk hoger. Meetbureau Artificial Analysis zet Le Chonk op gelijke hoogte met OpenAI's GPT-6 Luna, de hoogste score van een model buiten de VS en China. Maar ook daar staat GLM-5.3 erboven.
Het is daarmee het sterkste open model van het Westen, niet van de wereld. Pikant detail: sinds augustus verkoopt Mistral datzelfde GLM-5.3, van het Chinese Z.ai, gewoon aan zijn eigen klanten.
De voorsprong op cyberbeveiliging heeft een keerzijde. Volgens Cline, dat een programmeertool maakt, komt die vooral doordat Le Chonk minder vaak weigert dan modellen van Anthropic en OpenAI. Mistral ziet dat als voordeel voor beveiligers. Wetenschapsdirecteur Pierre Stock vertelde Reuters ook dat het model tijdens tests buiten zijn testomgeving probeerde te treden. Dat was verwacht en werd tegengehouden, zegt hij. Overheden en beveiligingsexperts krijgen eerst toegang tot een versie met minder beperkingen.
Europa betaalt mee
Achter Le Chonk zit het grootste investeringsbedrag dat een Europees techbedrijf ooit ophaalde: 3 miljard euro in september, bij een waardering van ruim 21 miljard. Samsung leidde de ronde. Het Nederlandse ASML is al langer investeerder en ook klant, net als Airbus en de bank HSBC.
Dat geld maakt verschil. Dinsdag schreven we nog over Kolibri van het Duitse Aleph Alpha, dat met een fractie daarvan vooral oudere modellen bleek te verslaan. Le Chonk speelt in een andere klasse.
Proberen kan nu al, als ontwikkelaar
Ontwikkelaars kunnen Le Chonk nu al als preview gebruiken via Mistral Studio, het platform voor bedrijven. Voor wie met gevoelige gegevens werkt, is één punt interessant: Mistral biedt een Europese versie aan die volgens het bedrijf volledig onder Europees recht draait, los van Amerikaanse cloudbedrijven.
Op 27 oktober verschijnen de modelgewichten, het 'brein' van het model, zodat bedrijven en overheden Le Chonk op hun eigen servers kunnen draaien. Dan kan iedereen ook nagaan hoe zwaar deze kat echt weegt.
🎯Jouw bedrijf in AI Report?
Bereik ruim 59.000 nieuwsbriefabonnees met interesse in AI. Sponsor onze nieuwsbrief of podcast. Laat je interesse weten.
🔮 Prompt Whisperer
Waarom je AI-chat steeds dommer wordt (en wat je eraan doet)
Je zit al een middag met je AI-assistent aan een rapport. Het begon goed: hij snapte de toon, onthield je opmerkingen en leverde precies wat je vroeg. Maar in de loop van de dag kantelt het. Hij schrijft weer bedragen in dollars terwijl je twee keer om euro's vroeg. En hij komt opnieuw aanzetten met het idee dat je een half uur geleden hebt afgeschoten.
Je bent niet gek. Dit heeft een naam: contextrot.
Dat klinkt enger dan het is. Het betekent dat een AI-model slechter wordt naarmate er meer tekst in het gesprek zit. Ook de nieuwste en slimste modellen hebben er last van, en een groter werkgeheugen lost het niet op. Uit onderzoek blijkt dat modellen al haperen lang voordat hun werkgeheugen vol zit.
Het goede nieuws: je kunt het voorkomen. Niet met een trucje per gesprek, maar door een klein kennissysteem op te zetten dat je AI elke keer opnieuw scherp zet. Zo maken wij deze nieuwsbrief ook.
Vandaag leer je hoe je:
herkent dat je gesprek aan het 'rotten' is, voordat de fouten in je werk sluipen;
een lang gesprek overzet naar een nieuwe chat zonder iets kwijt te raken;
je AI een eigen geheugenbestand laat bijhouden dat je zelf in de hand hebt;
dat geheugenbestand inricht voor jouw vak, of je nu klanten bedient of onderzoek doet;
elke nieuwe chat met één vaste zin laat beginnen waar de vorige ophield;
met vijf kant-en-klare prompts een kennissysteem opzet dat contextrot structureel verslaat.
Abonneer je om verder te lezen
Het verschil tussen een oké en een briljant AI-antwoord zit in de prompt. Word nog beter in prompten en laat AI écht voor jou werken.
Abonneer nuDit zit achter de betaalmuur:
- Praktische prompt-tips die je meteen kunt gebruiken
- Uitleg waarom ze werken, zodat je zelf betere prompts leert schrijven
- Variaties per vakgebied
- Toegang tot het volledige archief